스트리밍 시리즈에서 좋아하는 에피소드를 다시 본 적이 있다면, 아마 “지난 이야기…”로 시작하는 요약 장면을 본 적이 있을 것입니다. 이런 요약이 없다면, 내용을 다시 떠올리기 위해 이전 에피소드를 다시 보느라 시간을 낭비해야 할 수도 있습니다.
하지만 많은 AI 추론 시스템에는 이런 편의 기능이 없습니다. 사용자가 문서를 다시 열거나 이전 맥락을 다시 참조할 때, 모델은 이미 처리된 내용임에도 불구하고 처음부터 다시 계산하는 경우가 많습니다. 그 결과 GPU 연산 자원이 소모되고, 사용자는 이미 다뤘던 답변을 얻기 위해 수십 초를 기다려야 할 수 있습니다.
대규모 환경에서는 이 문제가 KV(Key-Value) 캐시에 저장된 컨텍스트 메모리를 넘어, 검색 증강 생성(RAG)을 구동하는 벡터 데이터베이스까지 확장됩니다. 그 결과, 지식을 검색 가능하게 유지하기 위해서만 메모리 비용이 급격히 증가하게 됩니다.
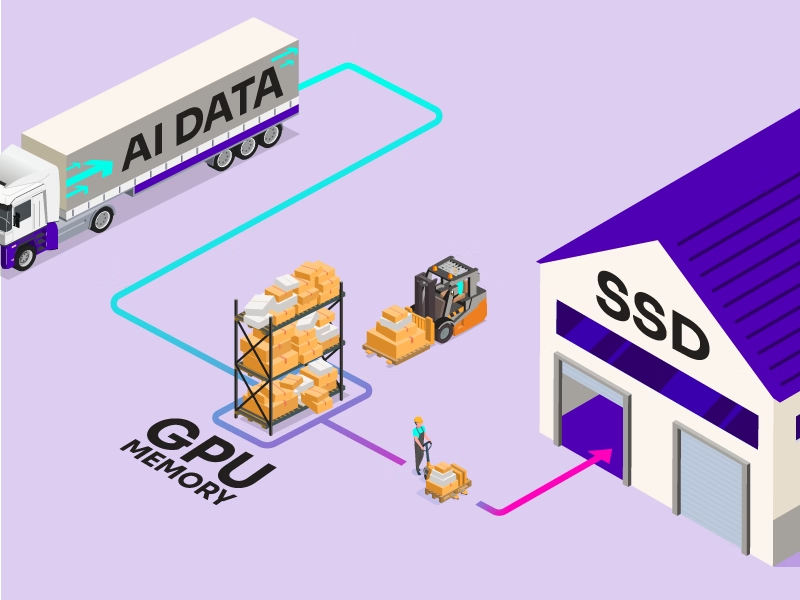
그 결과, AI는 너무 쉽게 잊어버리고 다시 기억하는 데는 지나치게 많은 비용이 드는 구조가 됩니다. Solidigm과 Metrum AI는 새로 발표한 백서에서 SSD를 활용하면 AI 시스템이 오래 지속되는 메모리를 갖출 수 있으며, 매번 데이터를 다시 불러올 때마다 높은 비용을 지불할 필요가 없다는 점을 보여줍니다. 이번 연구에는 스토리지 분야에서 깊은 전문성을 갖춘 데이터센터 인프라 제공업체FarmGPU도 참여했습니다.
AI 추론 파이프라인은 현재 두 가지 방향에서 동시에 확장되고 있습니다. 한편으로는 RAG 애플리케이션이 수억 개의 임베딩에 달할 수 있는 대규모 벡터 데이터베이스에 의존하고 있습니다. 반면, 대규모 언어 모델은 점점 더 긴 문맥을 처리하며, 빠른 응답 시간을 유지하기 위해 항상 접근 가능한 상태로 유지해야 하는 막대한 규모의 KV 캐시를 생성하고 있습니다.
기존에는 이 두 가지 문제를 더 많은 DRAM과 GPU 메모리를 추가하는 방식으로 해결해 왔습니다. 하지만 이러한 접근 방식은 이제 비용과 물리적 측면에서 뚜렷한 한계에 부딪히고 있습니다.
이번 연구에서는 1억 개 벡터 규모의 인메모리 벡터 인덱싱에는 300GB 이상의 DRAM이 필요한 것으로 나타났습니다. 동시에 약 18만 개 토큰으로 구성된 단일 장문 컨텍스트 문서만으로도 GPU VRAM의 90% 이상을 사용할 수 있어, 동시 처리나 재사용을 위한 여유 공간이 거의 남지 않습니다.
결국 가치가 증가하는 속도보다 비용이 더 빠르게 증가하는 구조가 됩니다.
이번 연구에서 가장 분명하게 확인된 결과 중 하나는 SSD로 오프로딩된 벡터 검색이 RAG의 비용 대비 성능 곡선을 근본적으로 변화시킨다는 점입니다.
Solidigm™ D7-PS1010 SSD에 저장된 벡터 데이터를 기반으로 DiskANN 인덱싱을 사용한 결과, 테스트 시스템은 1억 개 벡터 기준 DRAM 요구량을 331GB에서 116GB로 줄였으며, 정확도를 유지하면서도 65%의 감소를 달성했습니다. 실제로 대규모 환경에서도 재현율은 99% 이상을 유지했습니다.
성능 역시 개선되었습니다. 운영 환경을 반영한 동시 처리 수준(1,024 스레드)에서 SSD 오프로 기반 DiskANN은 DRAM 기반 HNSW 인덱싱보다 쿼리 처리량이 14% 더 높았으며, 평균 지연 시간과 테일 지연 시간도 더 낮게 나타났습니다. 이는 데이터를 스토리지로 이동하면 성능이 저하된다는 기존의 통념을 뒤집는 결과입니다.
RAG 파이프라인에 있어 이는 매우 중요한 의미를 갖습니다. 기업은 서버를 점점 더 큰 메모리 구조에 맞게 다시 설계할 필요 없이, SSD 용량을 추가하는 것만으로 지식 베이스를 수 백만 개 벡터에서 수억 개 벡터 규모로 확장할 수 있습니다.
벡터 검색은 이야기의 절반에 불과합니다. AI 추론에서 생기는 또 다른 주요 병목은 대규모 언어 모델의 어텐션 계산 과정에서 생성되는 KV 캐시입니다.
오프로딩이 없을 경우, 이전에 분석했던 문서를 다시 불러올 때 시스템은 전체 KV 캐시를 다시 계산해야 하며, 프롬프트가 큰 경우 첫 번째 토큰이 반환되기까지 30~40초가 걸릴 수도 있습니다. 특히 사용자가 여러 문서를 오가며 작업하는 경우, 이러한 지연은 조사 및 분석 워크플로우를 크게 저해합니다.
이 백서에서는 메모리 계층을 확장해 활성 KV 데이터는 GPU 메모리에 유지하고 추가 컨텍스트는 Solidigm SSD에 저장함으로써 이러한 사용자 경험이 어떻게 크게 개선되는지를 보여줍니다.
캐시된 KV 텐서를 다시 계산하는 대신 SSD에서 불러오면, 첫 번째 토큰이 반환되기까지 시간이 약 39초에서 1.43초로 줄어들어 약 27배의 성능 향상이 나타났습니다. 모델은 더 이상 동일한 컨텍스트를 두 번 처리할 필요가 없으며, GPU는 이미 수행한 작업을 반복하는 대신 인사이트를 생성하는 데 집중할 수 있습니다.
이 접근 방식은 메모리 제약을 받는 워크로드에서 GPU VRAM을 계속 확장해야 하는 부담도 줄여 줍니다. SSD는 데이터의 저장과 재사용을 위한 훨씬 더 비용 효율적인 계층을 제공합니다.
벡터 검색과 KV 캐시 오프로딩 전반에서 얻은 데이터는 하나의 일관된 결론을 제시합니다. SSD는 더 이상 단순한 저장 용량 계층이 아니라, 적절한 소프트웨어 아키텍처와 결합될 때 AI 추론에서 성능을 담당하는 핵심 계층으로 작동합니다.
합성 벤치마크와 실제 운영 환경 벤치마크 모두에서 SSD 오프로딩 기반 설계는 다음과 같은 성과를 보였습니다.
장기적으로 운영할 AI 시스템을 구축하려는 기업에게 이는 중요한 문제입니다. 2026년에도 메모리 가격은 불가피하게 상승 압력을 받고 있으며 GPU 자원은 여전히 매우 제한적입니다. 모든 데이터를 DRAM이나 VRAM에 두어야 한다는 전제에 기반한 아키텍처는 경제적으로 확장성이 떨어집니다.
핵심 메시지는 분명합니다. 대규모 AI 추론 시스템은 이제 고성능 SSD의 도움을 받는 수준을 넘어, 이를 필수 요소로 요구합니다.
RAG 데이터 구조와 KV 캐시를 고성능 NVMe SSD로 오프로딩하면 확장성, 응답성, ROI를 제한하던 메모리 장벽을 넘어설 수 있습니다. 그 결과 수요 증가에 따라 유연하게 확장하고, 일관된 성능을 제공하며 컴퓨팅 비용을 더욱 효율적으로 활용하는 AI 인프라를 구축할 수 있습니다.
AI가 매번 다시 학습하는 대신 기억하도록 함으로써, SSD는 추론 과정을 진정한 ‘지난 이야기(Previously on…)’ 경험으로 바꿉니다. 컨텍스트는 몇 초 만에 복원되고, GPU는 계속 생산적으로 활용되며, 인사이트를 얻기 위해 모든 것을 처음부터 다시 시작할 필요가 없습니다.
Metrum AI 백서 보기: 영상 분석에서 메모리 한계를 극복하는 방법 (백서)(Breaking Memory Barriers in Video Analytics White Paper)
Ace Stryker는 Solidigm의 AI & 에코시스템 마케팅 디렉터로, 회사의 데이터센터 스토리지 솔루션 포트폴리오를 위한 새로운 애플리케이션 발굴에 집중하고 있습니다.