BaM 및 GIDS를 갖춘 Solidigm™ SSD의 성능
Solidigm 엔지니어들은 GPU 사용을 극대화하고 학습 시간을 단축하기 위해 BaM 및 GIDS를 사용하여 데이터 센터의 데이터 병목 현상을 해결하고 있습니다.
BaM( Big Accelerator Memory) 및 GIDS(GPU Initiated Direct Storage) 소개
그래프 신경망(GNN)의 기하급수적인 성장과 복잡성으로 인해 AI 학습 인프라에 대한 수요가 증가하고 있습니다. IGBH와 같은 이기종 데이터 세트(수십억 개의 에지와 고차원 기능 포함)에는 스토리지와 GPU 메모리 간의 방대한 양의 데이터 이동이 필요합니다. CPU가 모든 데이터 전송을 처리하는 기존 스토리지 인프라는 데이터 병목 현상을 발생시키고 파이프라인을 중단시켜 GPU 활용도가 낮고 학습 시간이 길어집니다. 이 병목 현상은 두 개의 오픈 소스 연구 프로젝트를 통해 해결됩니다.
1. BaM(빅 액셀러레이터 메모리)
BaM은 GPU가 기존 CPU 모델 대신 NVMe SSD와의 스토리지 상호 작용을 관리할 수 있도록 하여 데이터 배치를 재고합니다. BaM은 스토리지 장치에서 대량 전송을 위해 GPU의 병렬 처리를 활용하는 사용자 지정 소프트웨어 스택을 사용하여 레거시 드라이버를 우회합니다.
2. GIDS(GPU 시작 직접 스토리지)
BaM을 보완하는 것은 BaM 소프트웨어 아키텍처 위에 구축된 GIDS 데이터 로더입니다. GIDS를 통해 GPU는 스토리지 I/O를 직접 시작하고 관리하여 GNN AI 학습에 대한 요구 사항을 구체적으로 해결함으로써 CPU 개입을 완전히 제거할 수 있습니다. BaM과 GIDS는 함께 대기 시간을 최소화하고, 처리량을 극대화하며, 최적의 활용을 위해 데이터로 GPU를 포화시킵니다.
BaM 및 GIDS에 대한 Solidigm 평가
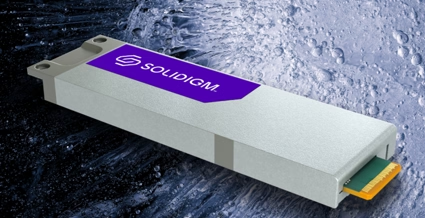
테스트에 사용되는 Solidigm™ D7-PS1010 SSD를 사용하면 BaM 및 GIDS 기술이 IGB 이기종 데이터세트와 같은 실제 GNN AI 학습 워크로드의 실질적인 가속기로 작동할 수 있습니다. 이 백서에서는 Solidigm D7-PS1010 SSD를 사용하여 수행한 BaM 및 GIDS 기술 평가 결과를 소개합니다.
학습을 위한 아키텍처
BaM 및 GIDS 를 사용한 GNN 학습용 아키텍처
GIDS는 데이터 로딩을 CPU에서 GPU로 전환하여 GNN 트레이닝을 가속화하도록 설계되었습니다. 기존의 CPU 바운드 mmap (메모리 매핑) 방식인 Deep Graph Library(DGL) 와 달리 GIDS는 BaM을 사용하여 Solidigm D7-PS1010 SSD에서 직접 GPU 데이터 전송을 활용하여 더 빠른 엔드 투 엔드 데이터 로딩을 제공하여 GNN 트레이닝의 효율성을 높입니다.
그림 1. GIDS 데이터 로더
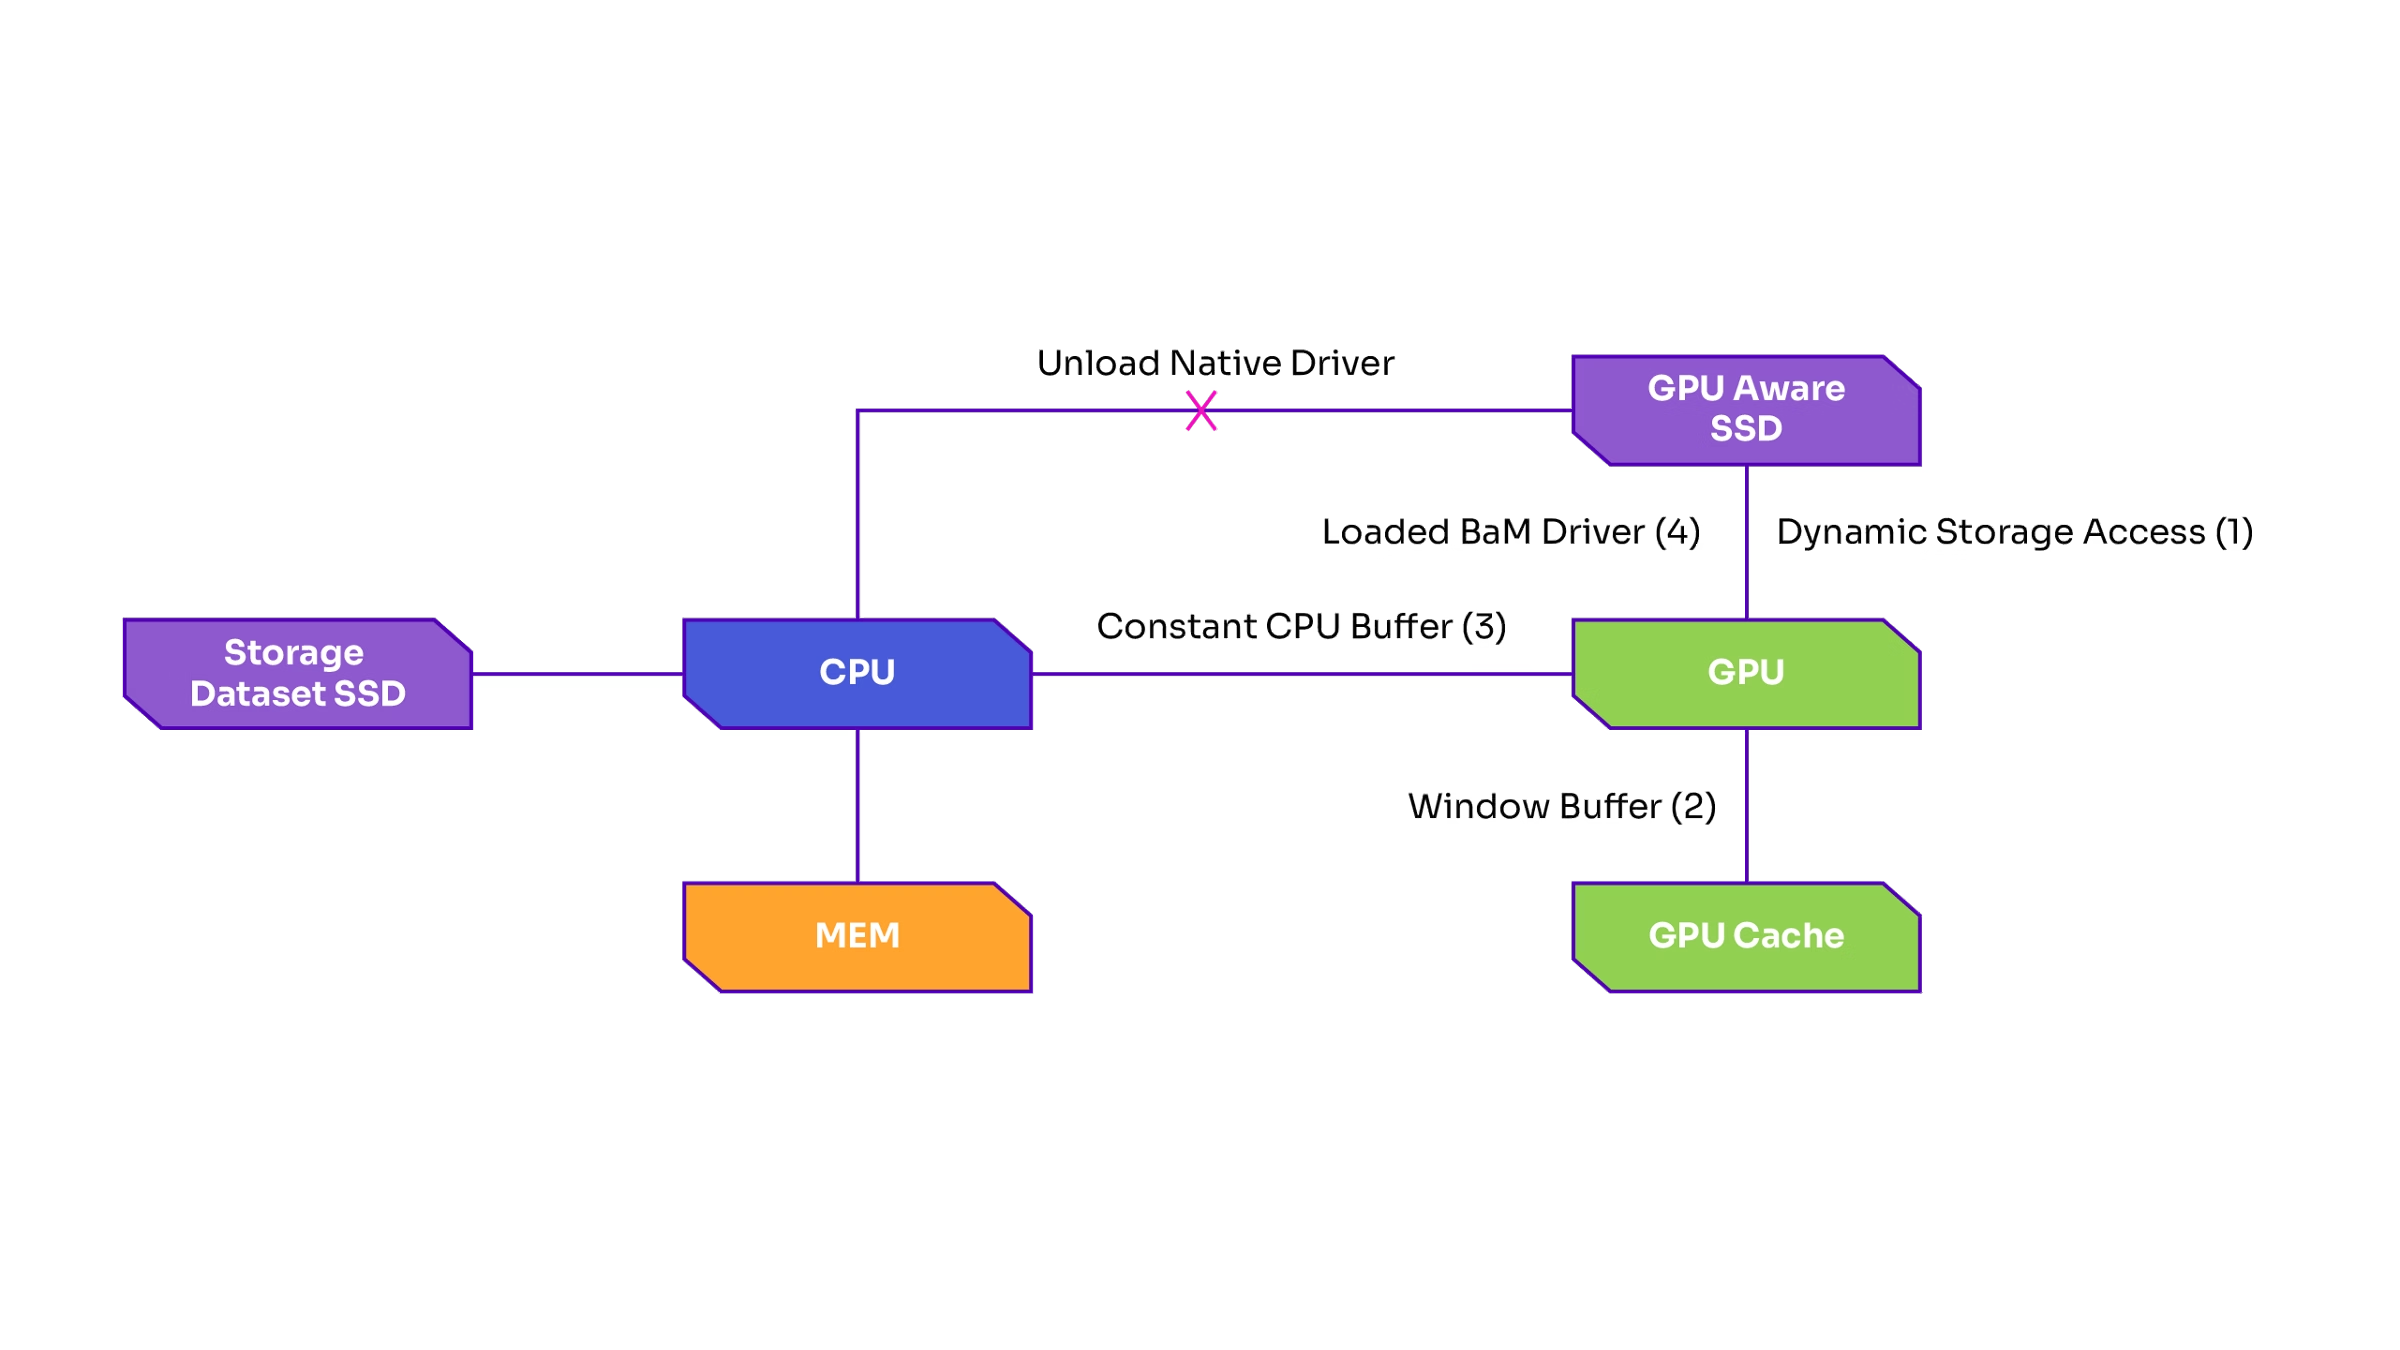
GIDS는 네 가지 주요 혁신을 통해 그래프 워크로드에 대한 스토리지 액세스를 최적화합니다.
- 동적 스토리지 액세스 누산기: GPU 스레드의 스토리지 요청을 연속 액세스 블록으로 비동기적으로 통합하여 최대 SSD 대역폭을 달성합니다.
- 윈도우 버퍼링: 향후 데이터 액세스 패턴을 예측하여 캐시 사용을 최적화하여 노드/에지 기능 로드 중 PCIe 버스가 멈추지 않도록 합니다.
- 고정 CPU 버퍼: 자주 액세스하는 데이터를 저장하기 위해 고정 크기의 핀 고정 메모리 영역.
- BaM 소프트웨어 스택: 사용자 지정 스토리지 드라이버를 사용하여 GPU의 병렬 처리를 활용합니다.
DGL mmap을 사용한 GNN 학습용 아키텍처
DGL mmap (Deep Graph Library의 메모리 매핑 I/O)은 그래프 데이터 로드에 대한 전통적인 CPU 기반 접근 방식입니다. GIDS 와 달리 특히 대규모 GPU 워크로드에서 성능 절충안을 제공합니다.
그림 2. 딥 그래프 라이브러리 로더
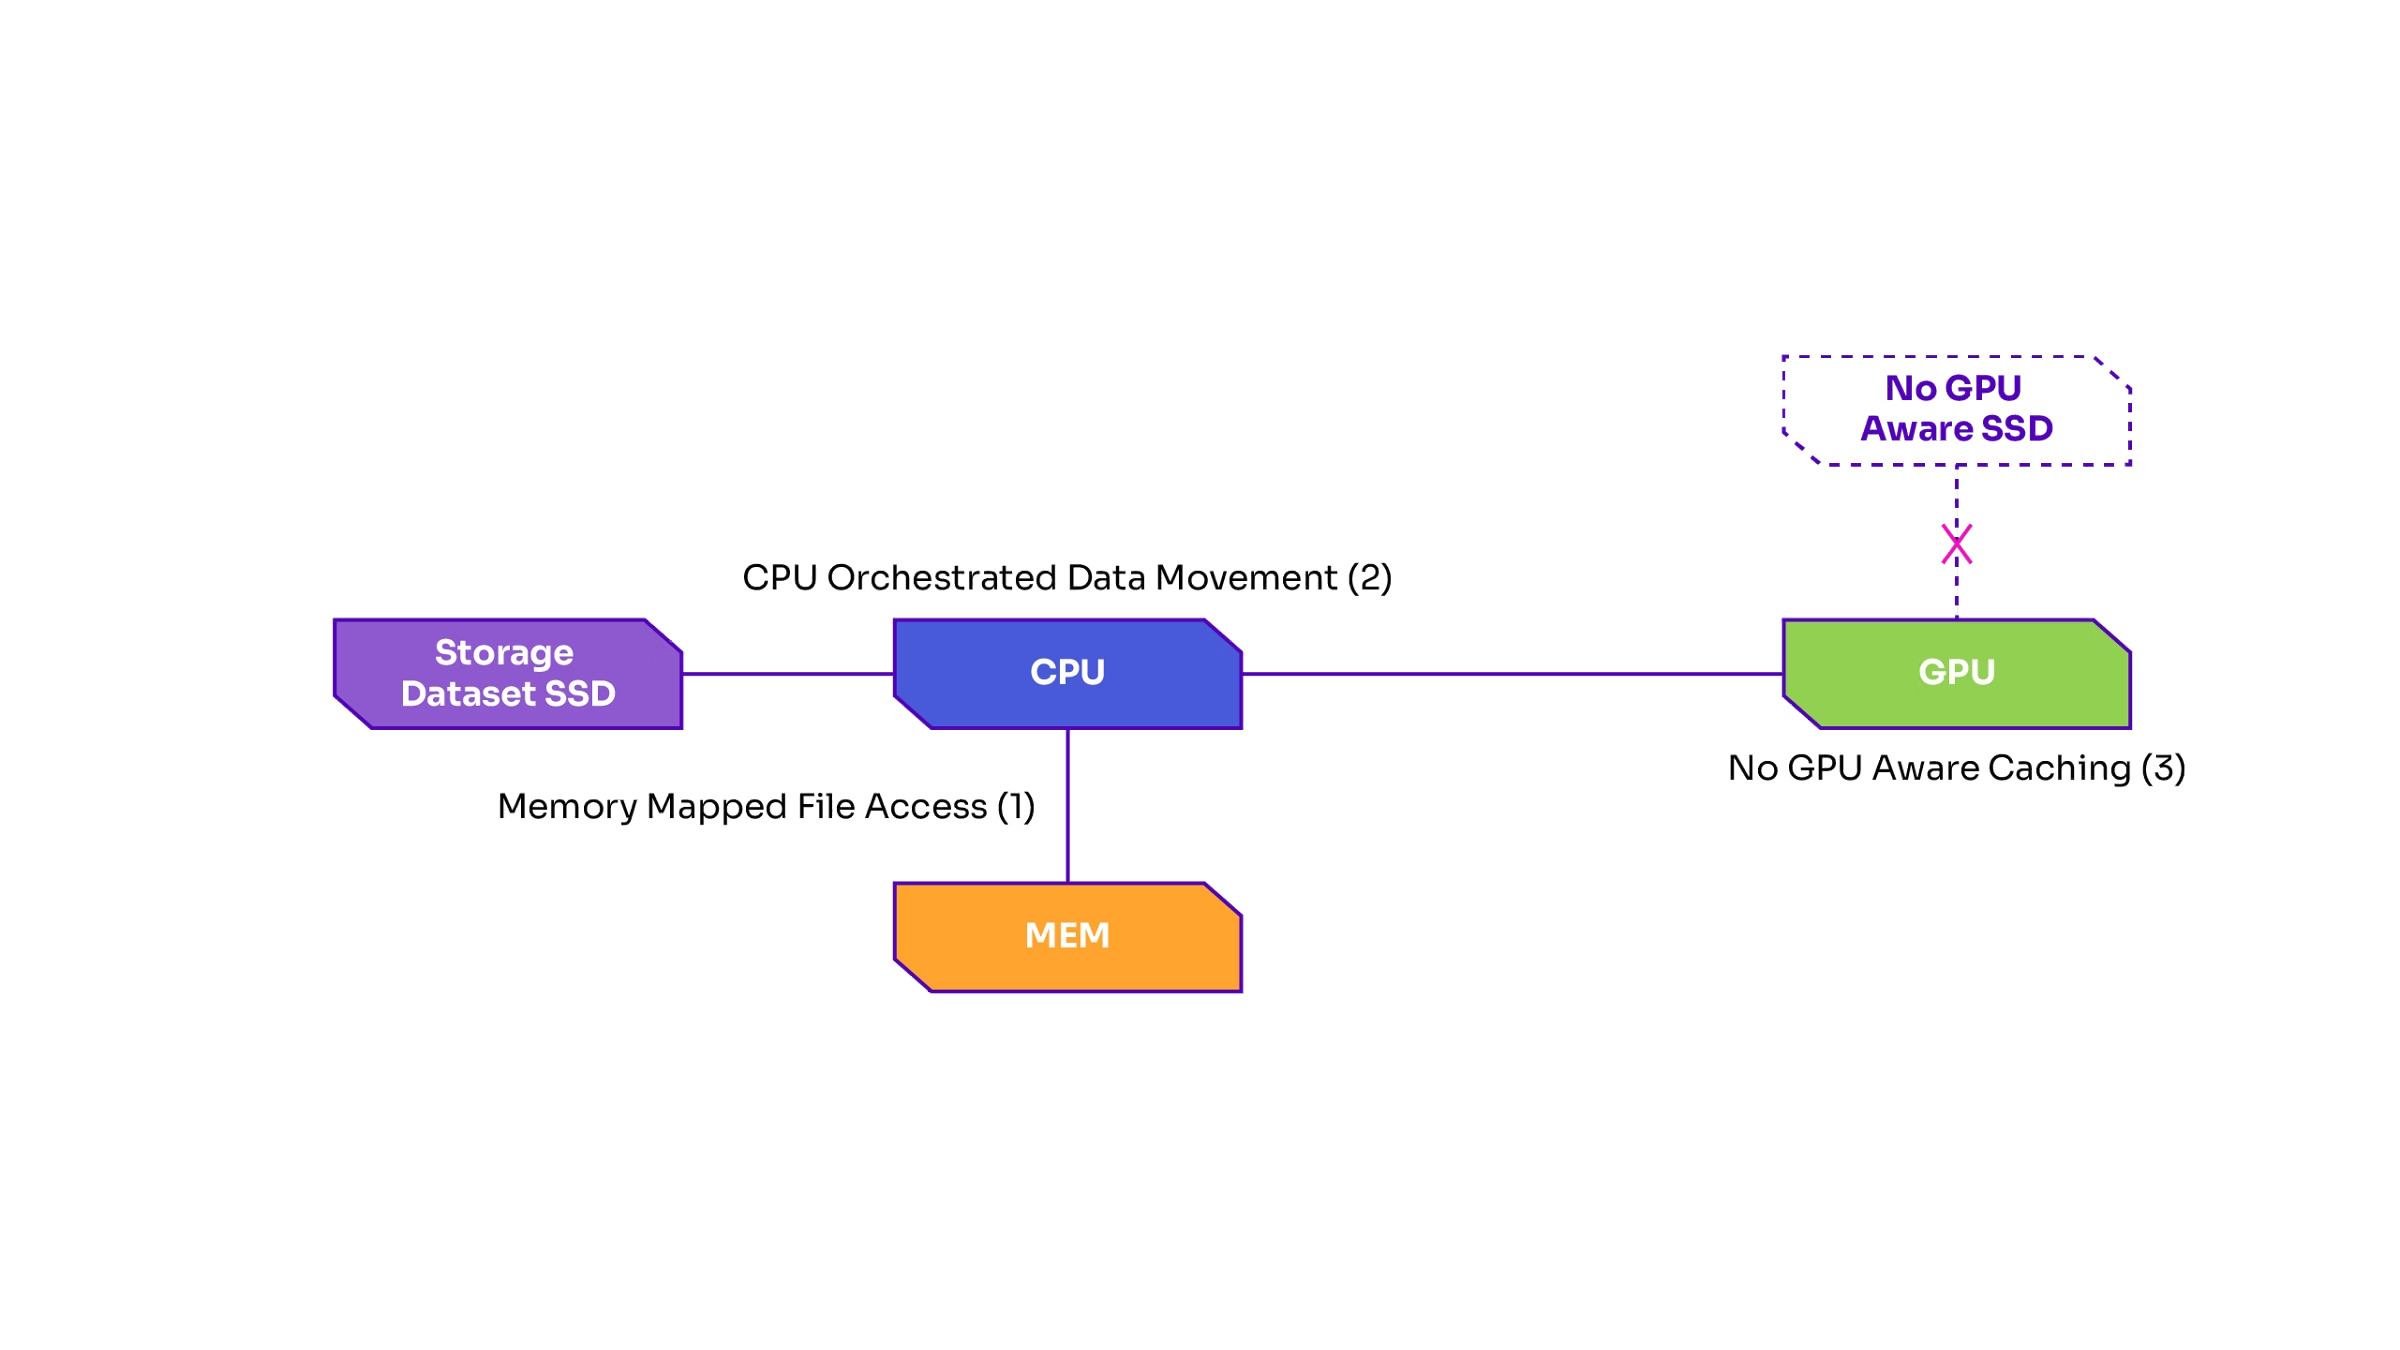
DGL mmap의 주요 특징:
- 메모리 매핑 파일 액세스: OS 수준 mmap을 사용하여 그래프 데이터(노드, 에지, 기능)를 가상 메모리에 매핑합니다.
- CPU 오케스트레이션 데이터 이동: CPU는 모든 데이터 액세스를 처리하고 PCIe를 통해 GPU로 전송합니다.
- GPU 인식 캐싱 없음: 예측 캐싱 또는 버퍼링 메커니즘이 부족합니다.
테스트 방법론
GIDS의 GPU 중심 아키텍처와 Solidigm D7-PS1010 SSD를 사용한 엔드 투 엔드 시간(100단계)과 DGL mmap을 사용한 데이터 로딩 효율성을 비교하고 있습니다. GNN 훈련을 위해 일리노이 그래프 벤치마크(IGBH)의 소규모 및 전체 이기종 데이터세트를 모두 테스트했습니다.
1. 시스템 구성
소프트웨어:
- OS: Ubuntu 20.04.05 LTS
- 커널: 5.8.0
- CUDA 12.9
- BaM
- GIDS 데이터 로더
- Python 딥그래프라이브러리
하드웨어:
- 서버: 슈퍼마이크로 SYS-421GE-TNRT
- CPU: 인텔 제온 실버 4516Y
- GPU: Nvidia L40S
- SSD: Solidigm™ D7-PS1010(E1.S, 3.84TB, PCIe 5.0 공냉식)
2. 벤치마크 파라미터
- 데이터세트: IGB 이종 소형(10M 에지), IGB 이종 풀(5.8B 에지)
- 기준: DGL mmap(CPU 중심 데이터 로더)
- 테스트 도구: GIDS 데이터 로더
- 측정 항목: 학습 중 100 단계에 대한 엔드 투 엔드 런타임(초).
- 각 단계에서는 2개의 레이어에 걸쳐 512개의 시드 노드 배치에 대해 이웃을 샘플링합니다.
- GNN 모델: 관계형 그래프 주의 네트워크(RGAT).
- 윈도우 버퍼링: 8GB
- 상수 CPU 버퍼: 데이터셋 크기의 20%.
벤치마크 정확도는 훈련 중 IGBH의 MLPerf 목표에 맞추기 위해 70%로 설정되었습니다. 참고: MLPerf는 다양한 워크로드에서 머신 러닝 성능을 평가하기 위한 업계 표준 벤치마크 제품군이며, 이 임계값은 모델이 의미 있는 수준의 수렴 및 품질에 도달했음을 나타냅니다.
공개적으로 액세스할 수 있는 코드 리포지토리를 사용하여 일리노이 그래프 벤치마크 제품군의 데이터 세트와 함께 GIDS 및 BaM을 활성화하고 실행했습니다. 링크는 부록을 참조하십시오.
3. 결과
IGBH 소형 데이터 세트(10M Edge)로 학습한 후 모델의 정확도
두 데이터 로더의 학습 정확도는 70%의 기준 임계값을 충족하여 학습 모델을 검증합니다.
그림 3. IGBH 소형 데이터 세트(10M Edge)로 학습한 후 모델의 정확도
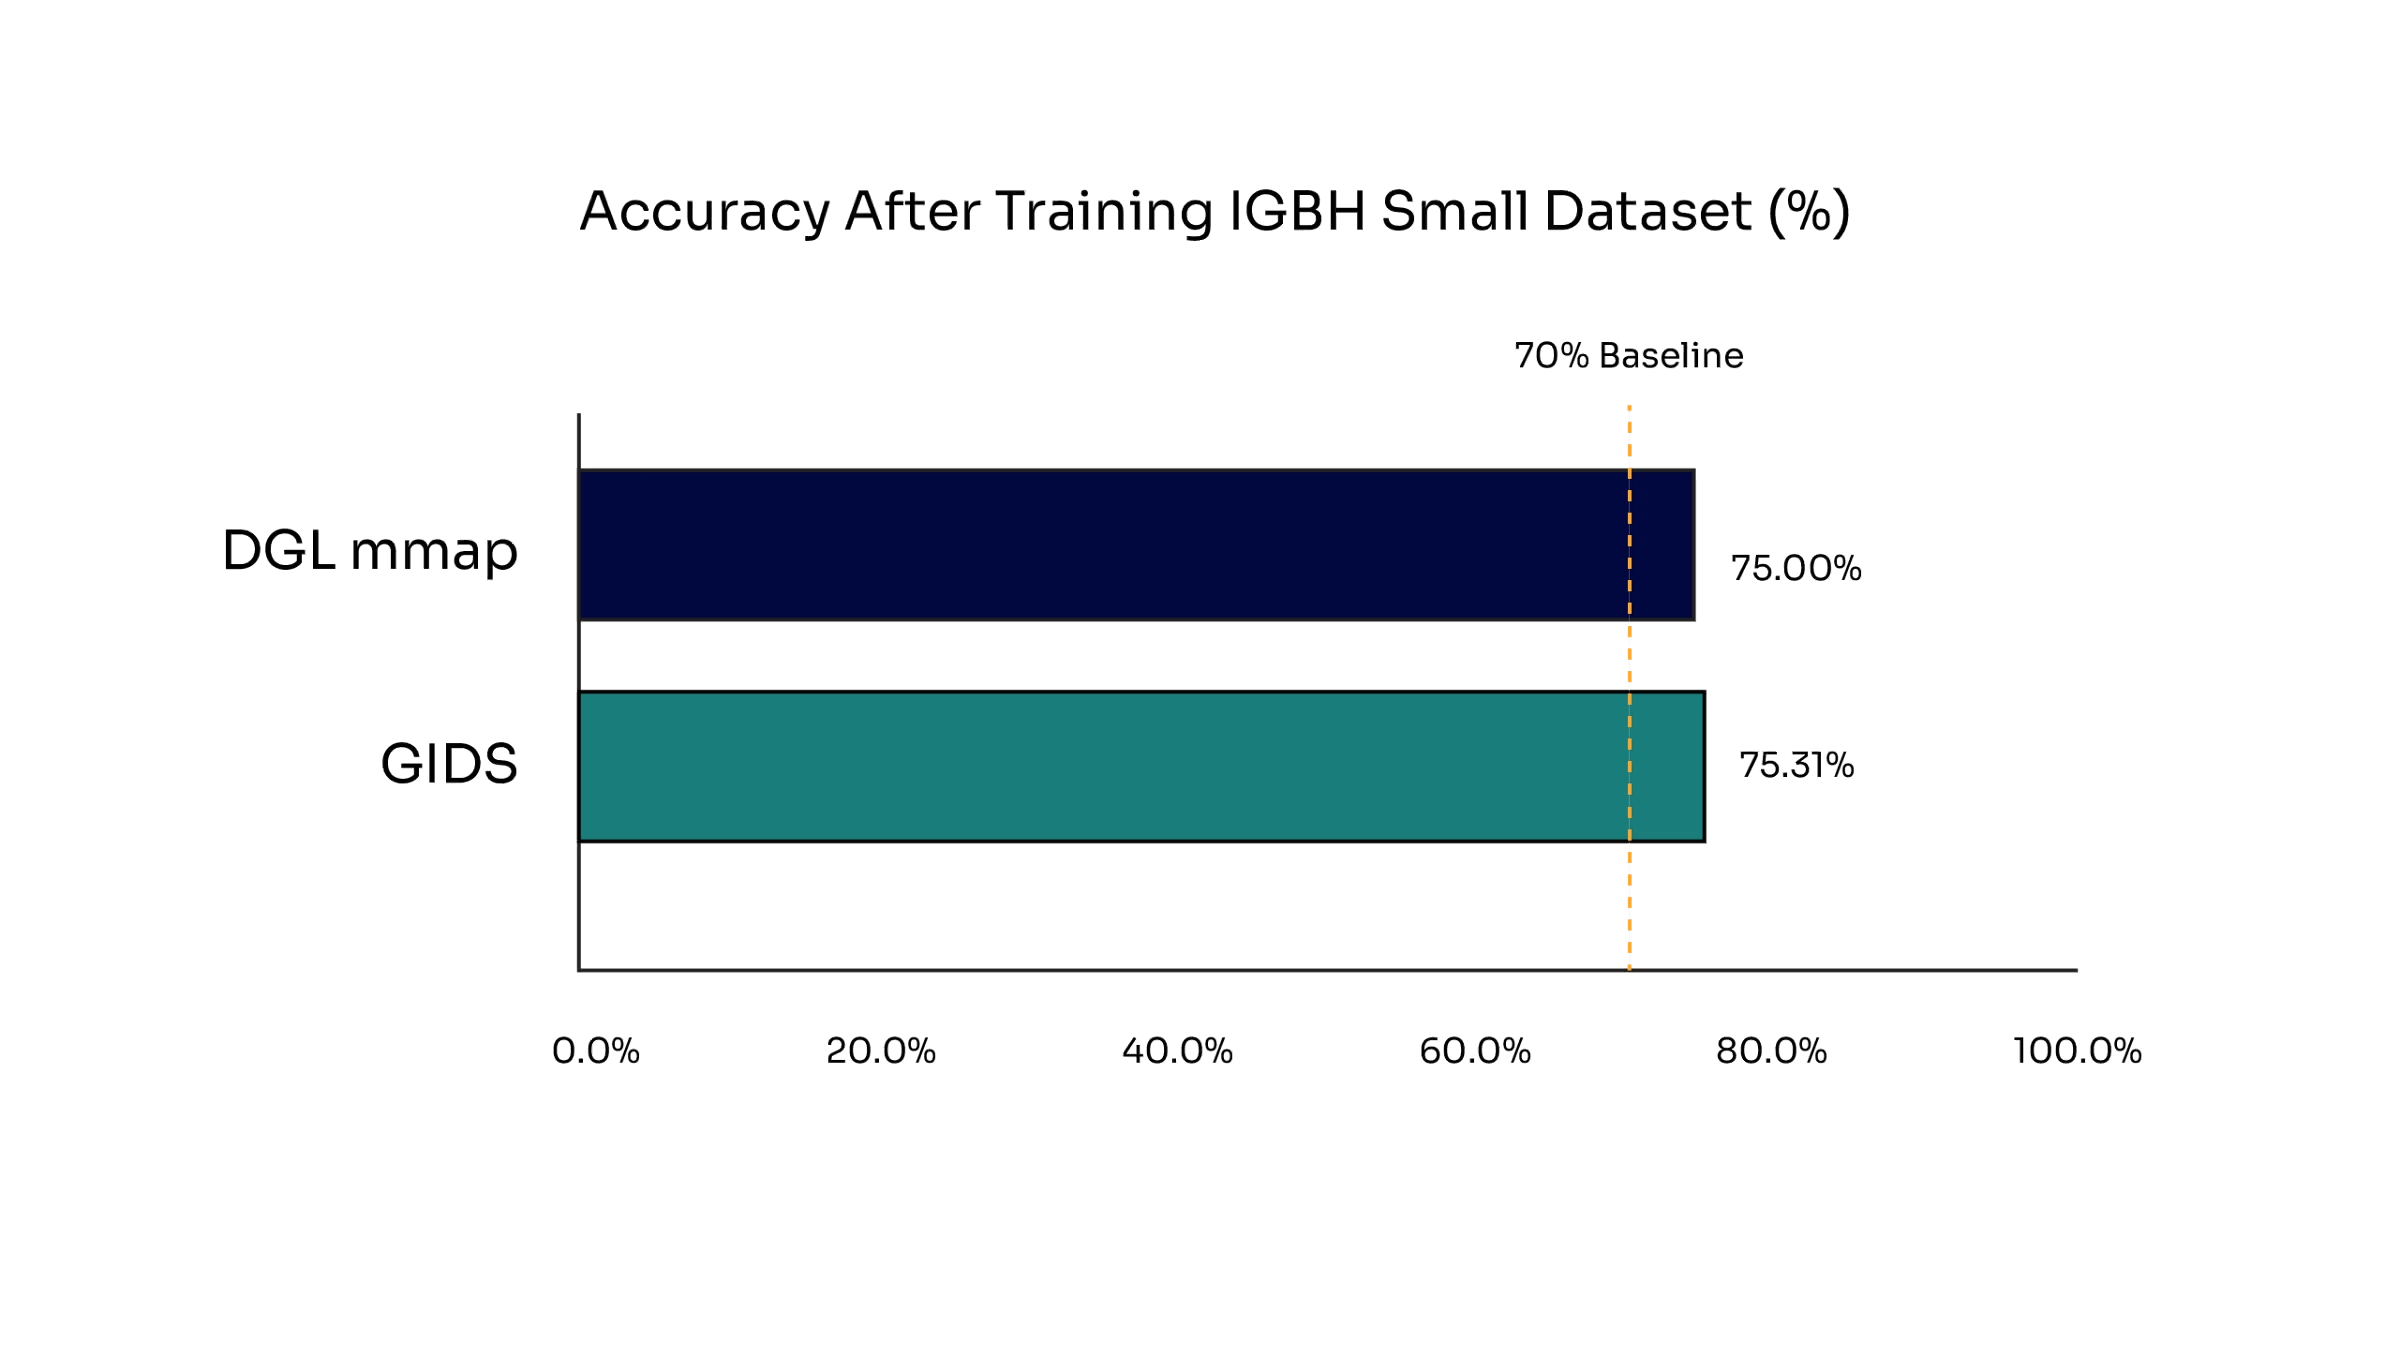
단일 Solidigm D7-PS1010 드라이브를 사용하여 100단계 동안 IGBH 소형 데이터세트(10M Edge)의 E2E 시간
GIDS는 Solidigm D7-PS1010 PCIe 5.0 SSD를 사용할 때 오버헤드를 최소화하고 병렬 처리를 활용하여 작은 그래프의 로드 시간을 거의 2배 단축합니다.
그림 4. IGBH 소형 데이터세트의 E2E 시간(10M 에지)
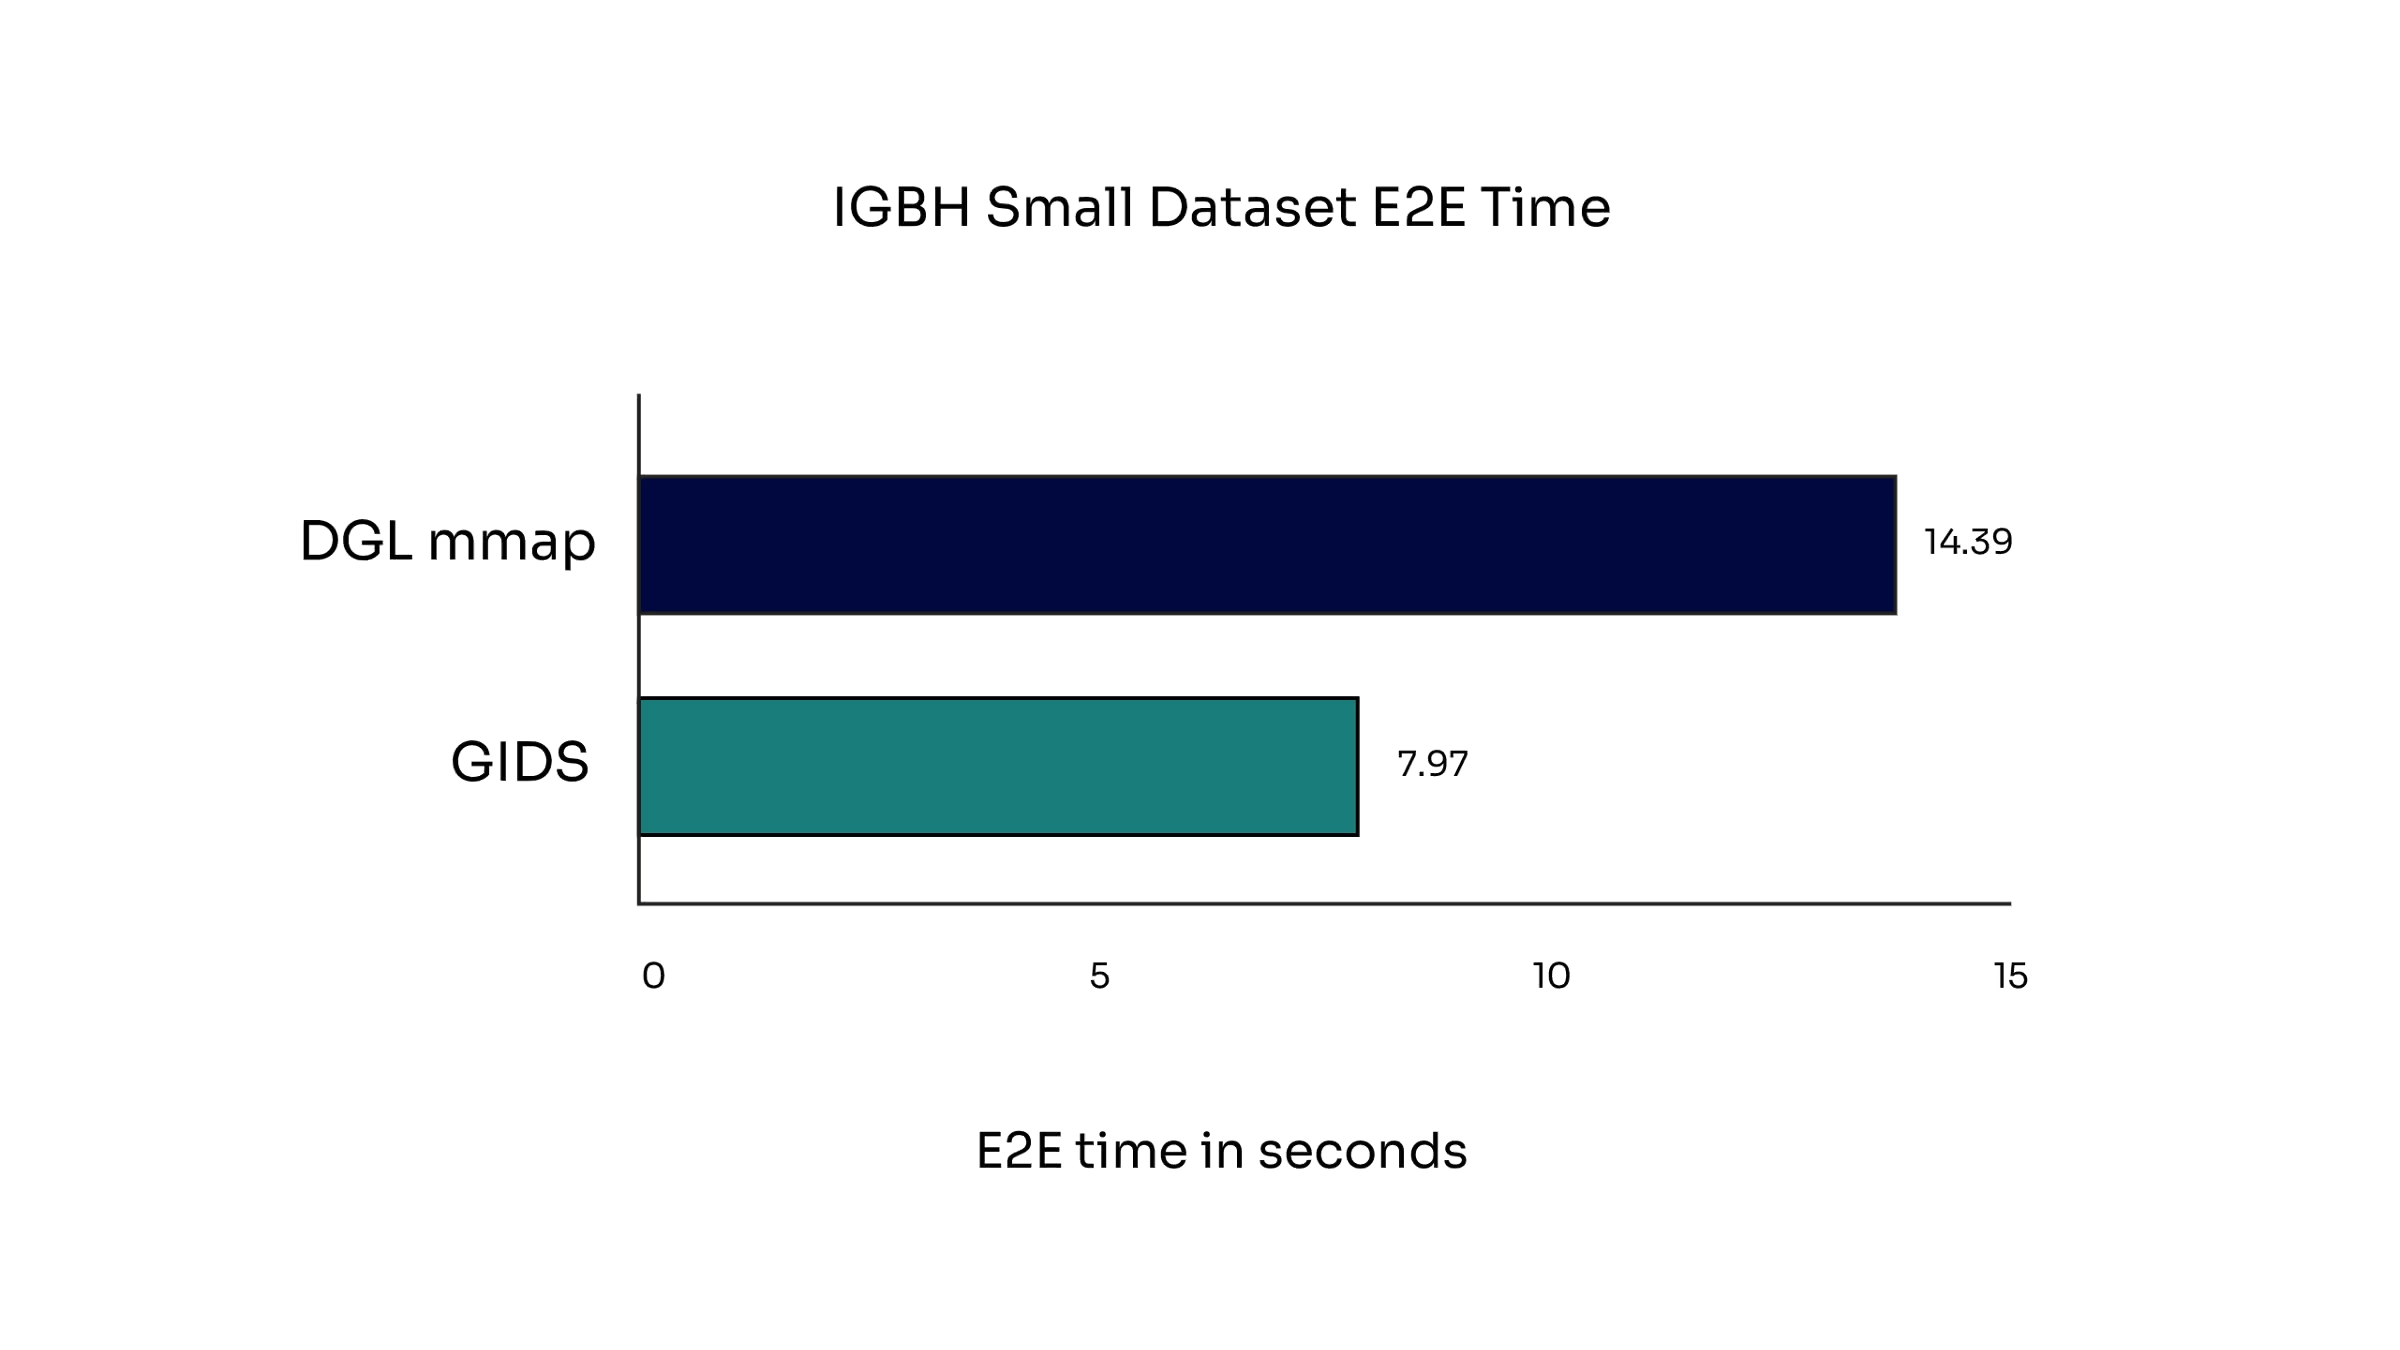
IGBH 전체 데이터 세트(5.8B 에지)로 학습한 후 모델의 정확도
두 데이터 로더의 학습 정확도는 학습된 모델을 검증하는 70%의 기준 임계값을 충족합니다.
그림 5. IGBH 전체 데이터 세트(5.8B 에지)로 학습한 후 모델의 정확도
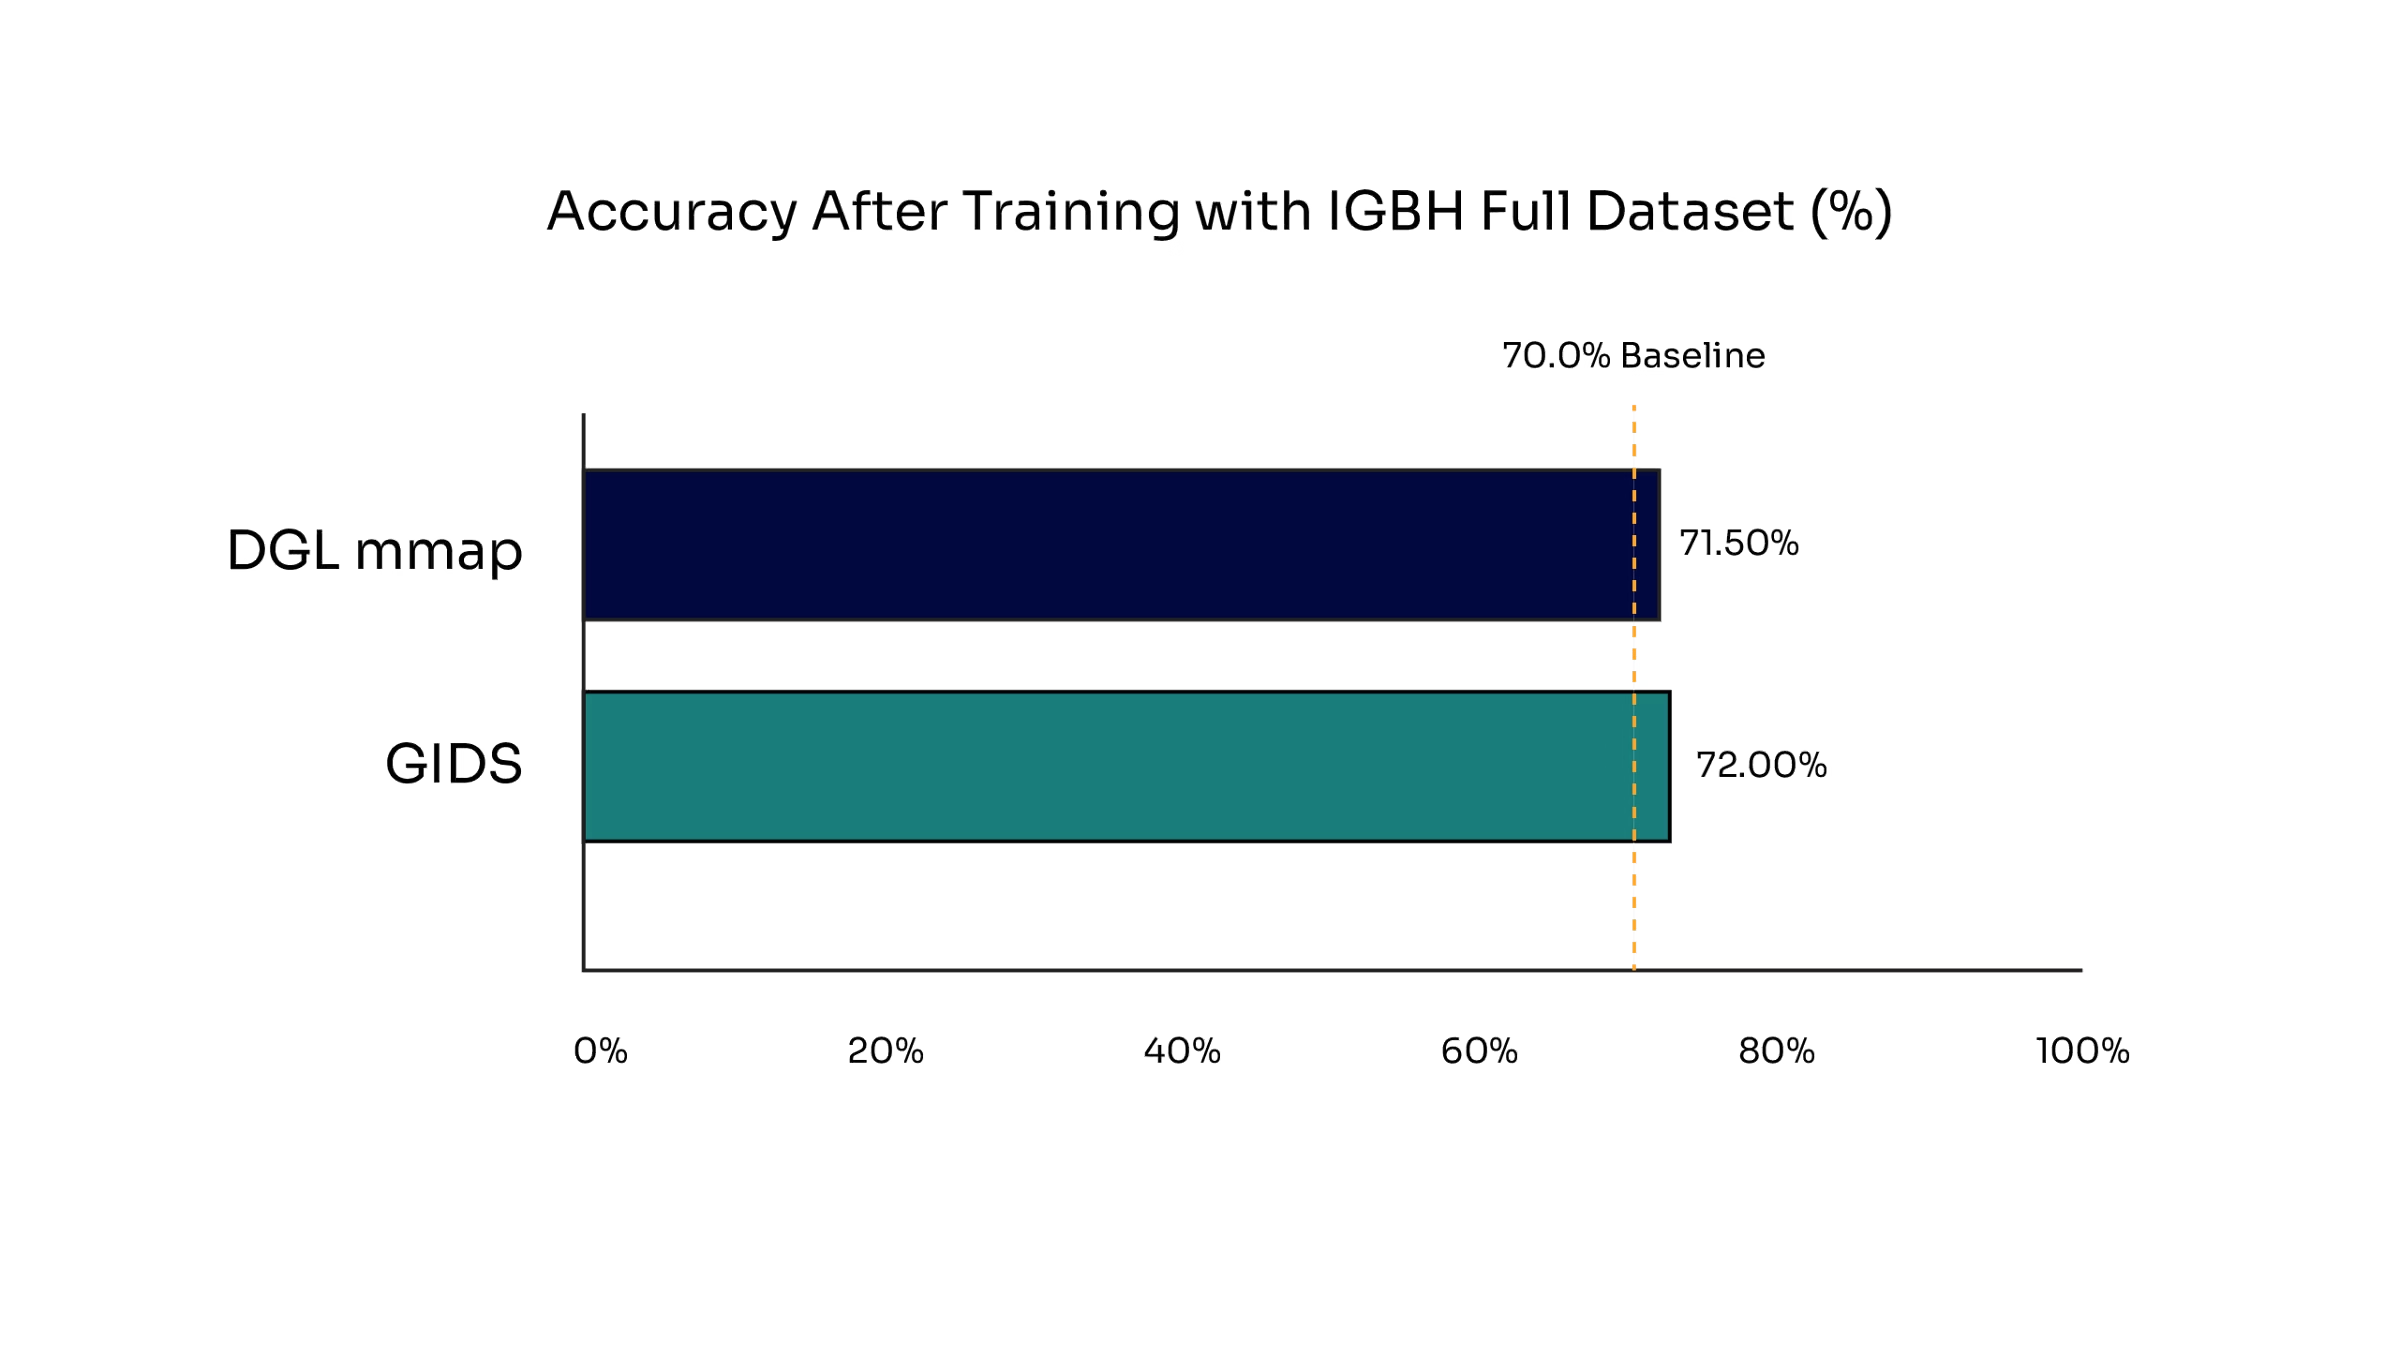
단일 Solidigm D7-PS1010 드라이브를 사용하여 100단계 동안 IGBH 전체 데이터 세트(5.8B 에지)의 E2E 시간
GIDS는 DGL mmap에 비해 에지가 거의 9배 증가하면서 확장됩니다.
그림 6. IGBH 전체 데이터 세트의 E2E 시간(5.8B 에지)
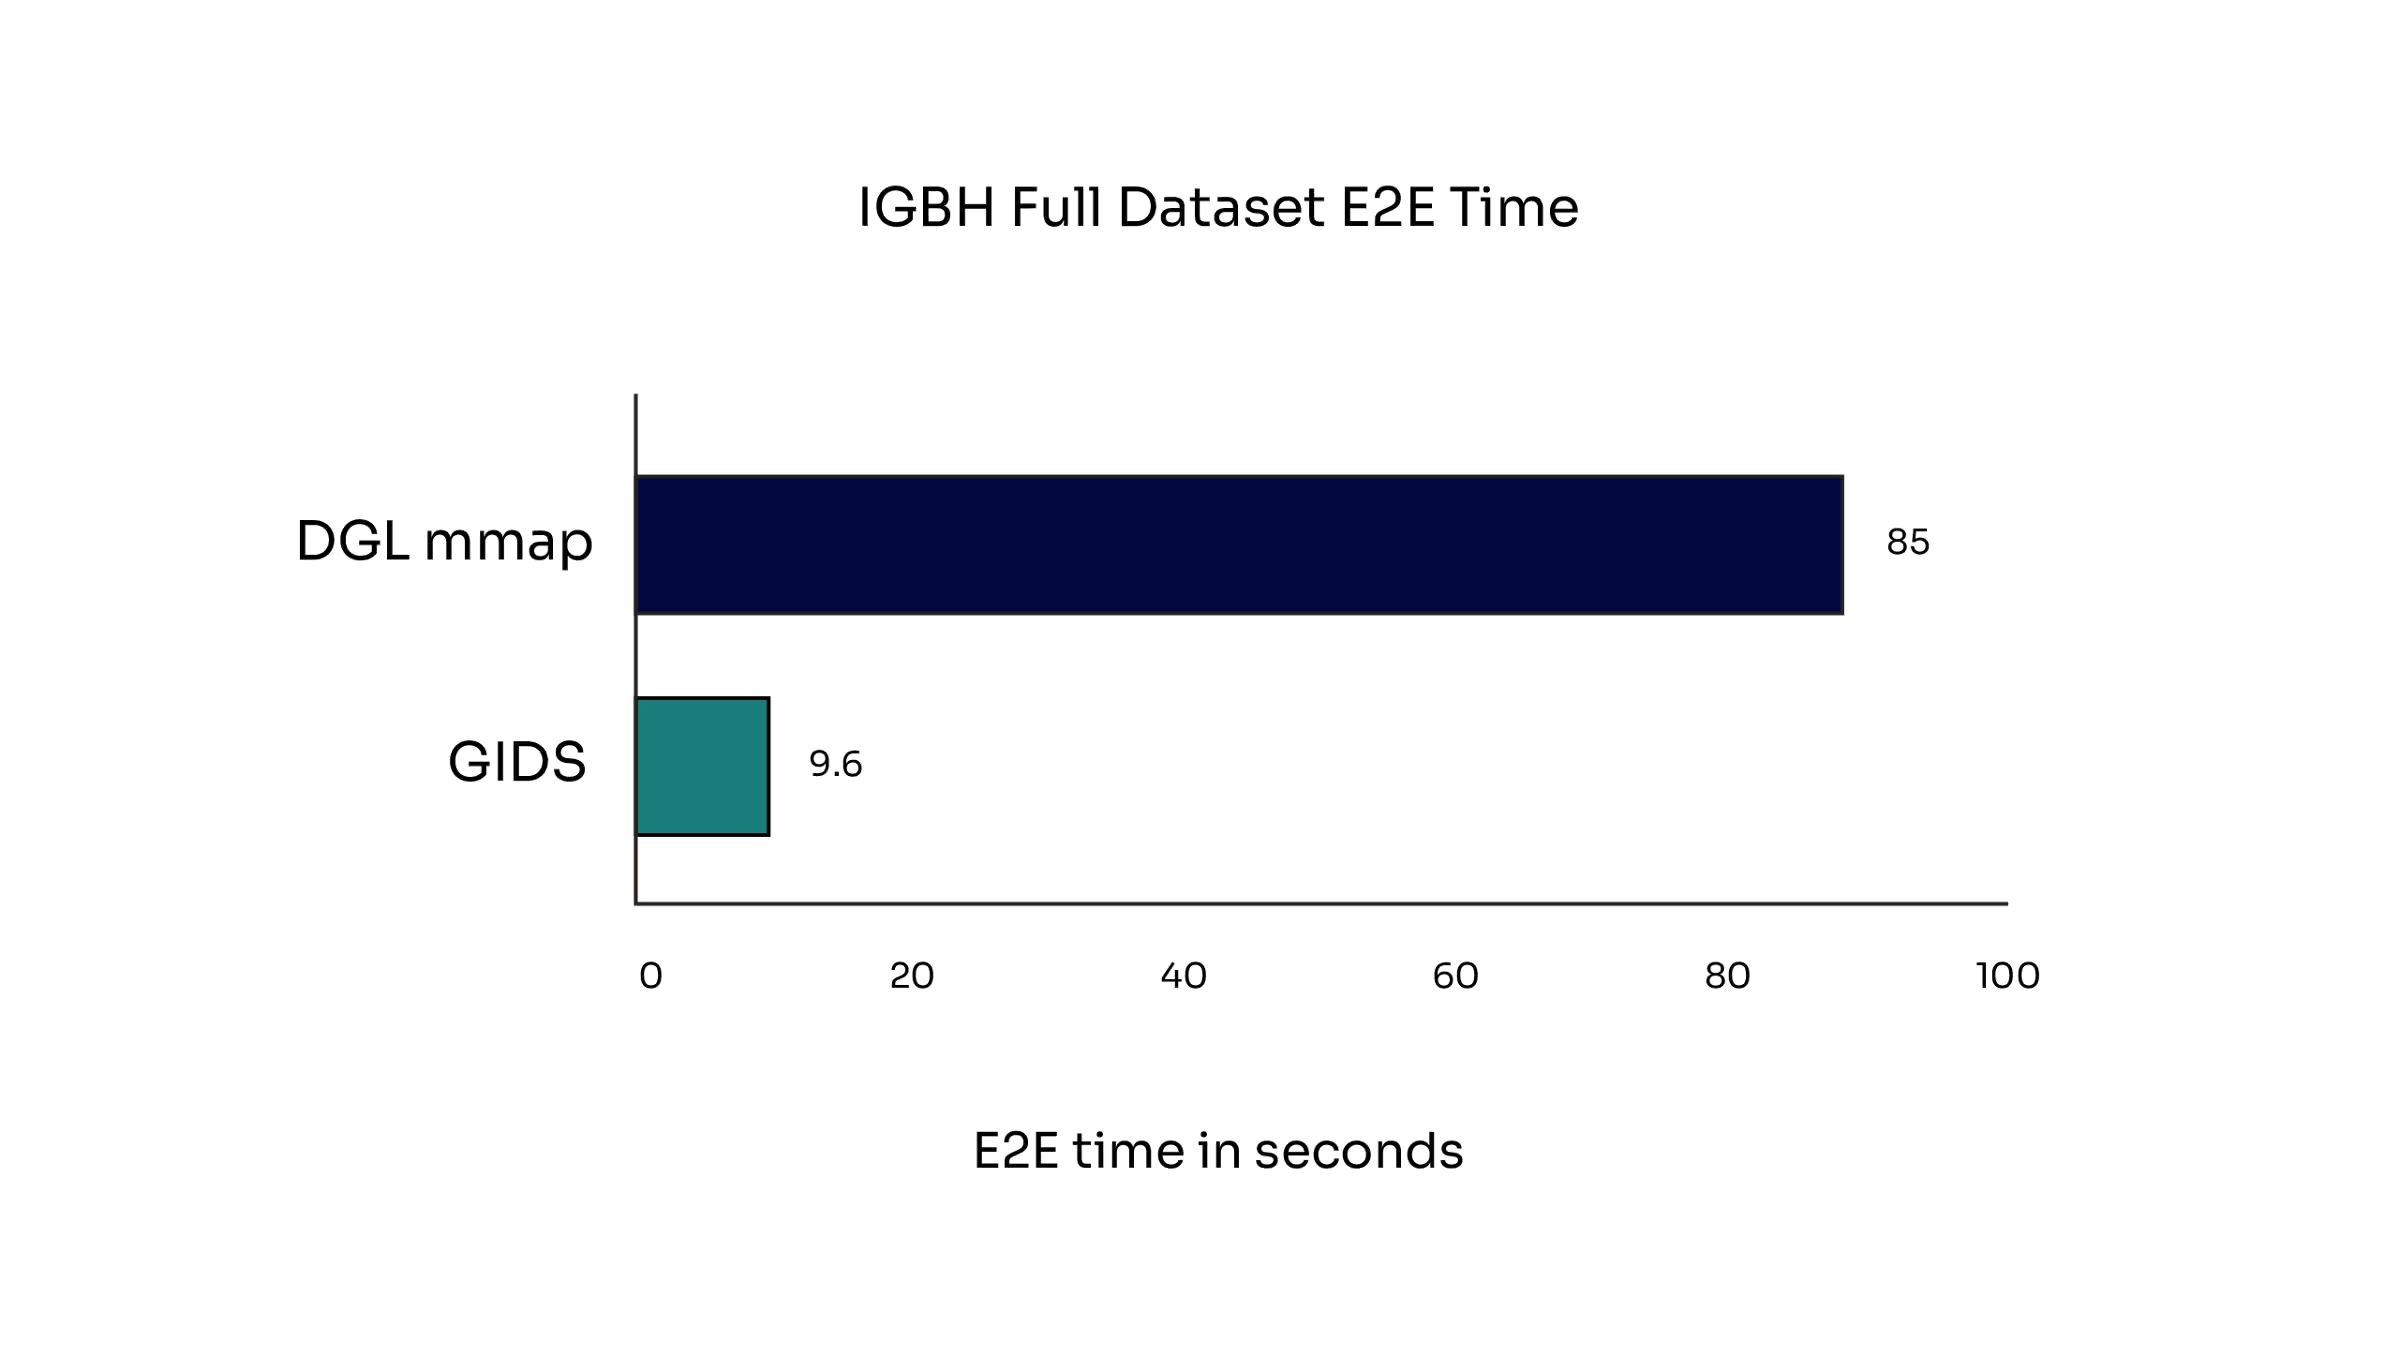
IGBH 데이터세트와 함께 BaM 및 GIDS를 사용할 때 GPU 캐시 메트릭 달성
| 데이터 세트 | 캐시 적중률 | 캐시 누락률 |
|---|---|---|
| 소규모 | 77.49% | 22.51% |
| 전체 | 10.80% | 89.20% |
표 1. IGBH 데이터 세트와 함께 BAM & GiDS를 사용할 때 달성된 GPU 캐시 메트릭
표 1은 IGBH 이종 그래프의 두 데이터 세트 스케일(소형 대 전체)에서 GIDS 데이터 로더를 사용하여 GNN을 훈련할 때 GPU 캐시 성능 메트릭을 비교합니다. 메트릭에는 다음이 포함됩니다.
- 캐시 적중률: BAM의 SSD가 아닌 소프트웨어 캐시(GPU 윈도우 버퍼, 상수 CPU 버퍼를 포함한 다중 계층 캐시)에서 제공되는 기능 가져오기 요청의 백분율입니다.
- 캐시 누락률: 데이터가 소프트웨어 캐시에 없기 때문에 BAM의 SSD에서 가져와야 하는 요청의 비율입니다.
캐시 적중률과 누락 비율은 작은 데이터세트와 전체 데이터세트 간에 크게 다릅니다(작은 실행의 경우 77% 적중률 대 전체 데이터세트의 경우 약 10%). 그러나 GPU 컴퓨팅이 학습 루프를 지배하고 I/O와 겹치기 때문에 이는 엔드 투 엔드 시간 격차로 이어지지 않습니다. 데이터는 사전 가져오기를 통해 BaM 을 통해 미리 캡처되고 액세스되므로, SSD 읽기는 계산 중에 효율적으로 처리되어 캐시 누락이 전체 런타임에 미치는 영향을 줄입니다.
DeepGraphLibrary 메서드는 소프트웨어 캐시 액세스를 보고하기 위한 GPU 소프트웨어 캐싱 또는 SSD 인식 프리페치 메커니즘이 없기 때문에 테이블에 포함되지 않습니다.
결론 및 향후 방향
Solidigm D7-PS1010 SSD는 GNN 훈련을 위해 BaM 및 GIDS 기술과 함께 사용할 때 성능 향상을 실현합니다.
- Solidigm D7-PS1010 SSD의 빠른 순차 및 랜덤 읽기 기능을 활용하여 BaM 및 GIDS와의 통합으로 대규모 그래프 데이터 세트의 수집 및 준비를 가속화합니다.
- GIDS는 데이터 로드 시간을 크게 줄여 기존 CPU 결합 DGL mmap 접근 방식에 비해 IGBH-소형 데이터 세트(10M 에지)에 대해 최대 2배 더 빠른 로드를 달성합니다.
평가된 최대 데이터 세트인 IGBH 전체 데이터 세트(58 억 개의 에지)의 경우 , GIDS는 레거시 방법보다 9배 빠른 고속 데이터 로딩을 유지합니다. BaM 및 GIDS에 대한 당사의 작업은 향후 스토리지 구성을 위한 Solidigm D7-PS1010 SSD의 준비에 대한 견고한 기반을 마련합니다.
Ashwin Pai는 Solidigm의 시스템 검증 엔지니어로, 소프트웨어, 하드웨어 및 시스템 엔지니어링 분야에서 약 10년에 육박하는 경력을 보유하고 있습니다. 그는 AI 및 데이터 집약적 워크로드에 최적화된 플랫폼을 포함하여 다양한 플랫폼에 걸쳐 차세대 SSD 기술을 검증하는 데 주력하고 있습니다. Ashwin은 고급 AI 방법론과 획기적인 혁신 기술을 활용하여 다양한 기능을 넘나드는 팀과 협업하며 AI 기반 환경에서 Solidigm SSD의 기능을 향상시킵니다. 그는 VES Institute of Technology의 전자공학 학사 학위와 North Carolina State University의 컴퓨터 공학 석사 학위를 보유하고 있습니다.
Akhil Srinivas는 Solidigm의 전기 및 시스템 엔지니어입니다. 그는 업계를 선도하는 에코시스템 업체들과 협력하여 최첨단 스토리지 솔루션을 위한 Solidigm SSD를 검증합니다. 그는 새로운 AI 기술과 선구적인 혁신을 활용하여 Solidigm SSD를 차세대 플랫폼의 중요한 구성 요소로 자리매김하고, AI 분야의 파트너십을 강화합니다. 기업 활동 외에, 그는 전국의 유명한 푸드 트럭과 레스토랑을 탐방하는 미식 탐험을 즐깁니다. Akhil은 R.V. College of Engineering의 통신공학 학사 학위와 University of California, Davis의 전기컴퓨터공학 석사 학위를 보유하고 있습니다.
Solidigm D7 PS1010 SSD E1.S 폼 팩터 정보
Solidigm D7-PS1010 E1.S는 AI 워크로드를 위한 최고의 SSD입니다. E1.S D7-PS1010은 특정 AI 서버 환경을 대상으로 하는 다음 폼 팩터로 제공됩니다.
| 폼 팩터 | 용량 | |||
|---|---|---|---|---|
| 3.84TB | 7.68TB | 3.84TB | 7.68TB | |
| 9.5mm |
|
|
|
|
| 15mm |
|
|
|
|
Solidigm 3.84TB E1.S D7 PS1010에 대한 자세한 내용은 다음을 참조하십시오.
BaM 및 GIDS 도구 및 스크립트에 대한 다음 링크를 참조했습니다.
©2026, Solidigm. “Solidigm”은 SK hynix NAND Product Solutions Corp(d/b/a Solidigm)이 미국, 중국, 싱가포르, 일본, 유럽연합, 영국, 멕시코 및 기타 국가에 등록된 상표입니다.
기타 명칭 및 브랜드는 해당 소유 업체의 자산입니다.
Solidigm은 언제든 고지 없이 양 및 제품 설명을 변경할 수 있습니다.
테스트는 특정 시스템의 특정 시험에서 구성 요소의 성능을 기록한 것입니다.
하드웨어, 소프트웨어 또는 구성에 따른 차이점이 실제 성능에 영향을 미칠 수 있습니다.
구매를 고려할 때 다른 정보를 참고하여 성능을 평가하십시오.
이러한 결과는 잠정적인 결과이며 정보 제공 목적으로만 제공됩니다. 이러한 가치 및 주장은 최종적이거나 공식적이지 않습니다.
드라이브는 엔지니어링 샘플로 간주됩니다. 생산 지침은 로드맵을 참조하십시오.